1. CONTEXTO HISTÓRICO Y JUSTIFICACIÓN TÉCNICA
La Deuda Técnica y el Punto de Inflexión
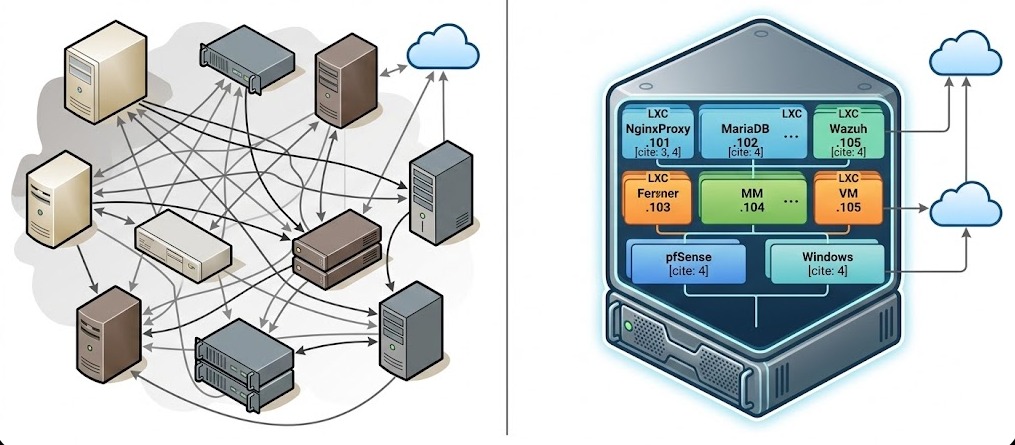
Aproximadamente hace dos años, la situación de la infraestructura heredada se volvió insostenible. Teníamos un escenario clásico de «crecimiento orgánico descontrolado»: múltiples servidores virtuales qemu dedicados a tareas únicas, sistemas operativos dispares sin centralización de actualizaciones, y un (des)orden que empezaba a parecerse a un plato de espaguetis de direcciones IP.
El modelo anterior, aunque funcional en sus inicios, generaba una deuda técnica crítica. Cada cambio suponía un riesgo alto de rotura, y la escalabilidad era nula. No podíamos levantar un entorno de pruebas para un cliente sin comprometer hardware físico o lidiar con incompatibilidades de librerías.
La Decisión de Proxmox VE
La migración a Proxmox VE no fue caprichosa. Se barajaron opciones como ESXi o Hyper-V, pero la flexibilidad de KVM para VMs pesadas y, sobre todo, la eficiencia de los contenedores LXC para microservicios web, inclinó la balanza. Además, el hecho de ser Open Source basado en Debian nos daba un control total sobre el sistema base, algo vital para nuestra política de autogestión.
El objetivo perfecto, y como último objetivo de esta gran migración, era consolidar todo el hierro en un hipervisor centralizado, reducir el consumo energético, y profesionalizar la gestión mediante plantillas, snapshots y una red virtualizada inteligente.
2. TOPOLOGÍA DE ALMACENAMIENTO FÍSICO (THE BACKBONE)
Para soportar la carga operativa de todo el cluster web y los servicios multimedia, no podíamos escatimar en el almacenamiento. No heredamos discos viejos; diseñamos una solución de almacenamiento híbrido basada en la criticidad del dato.
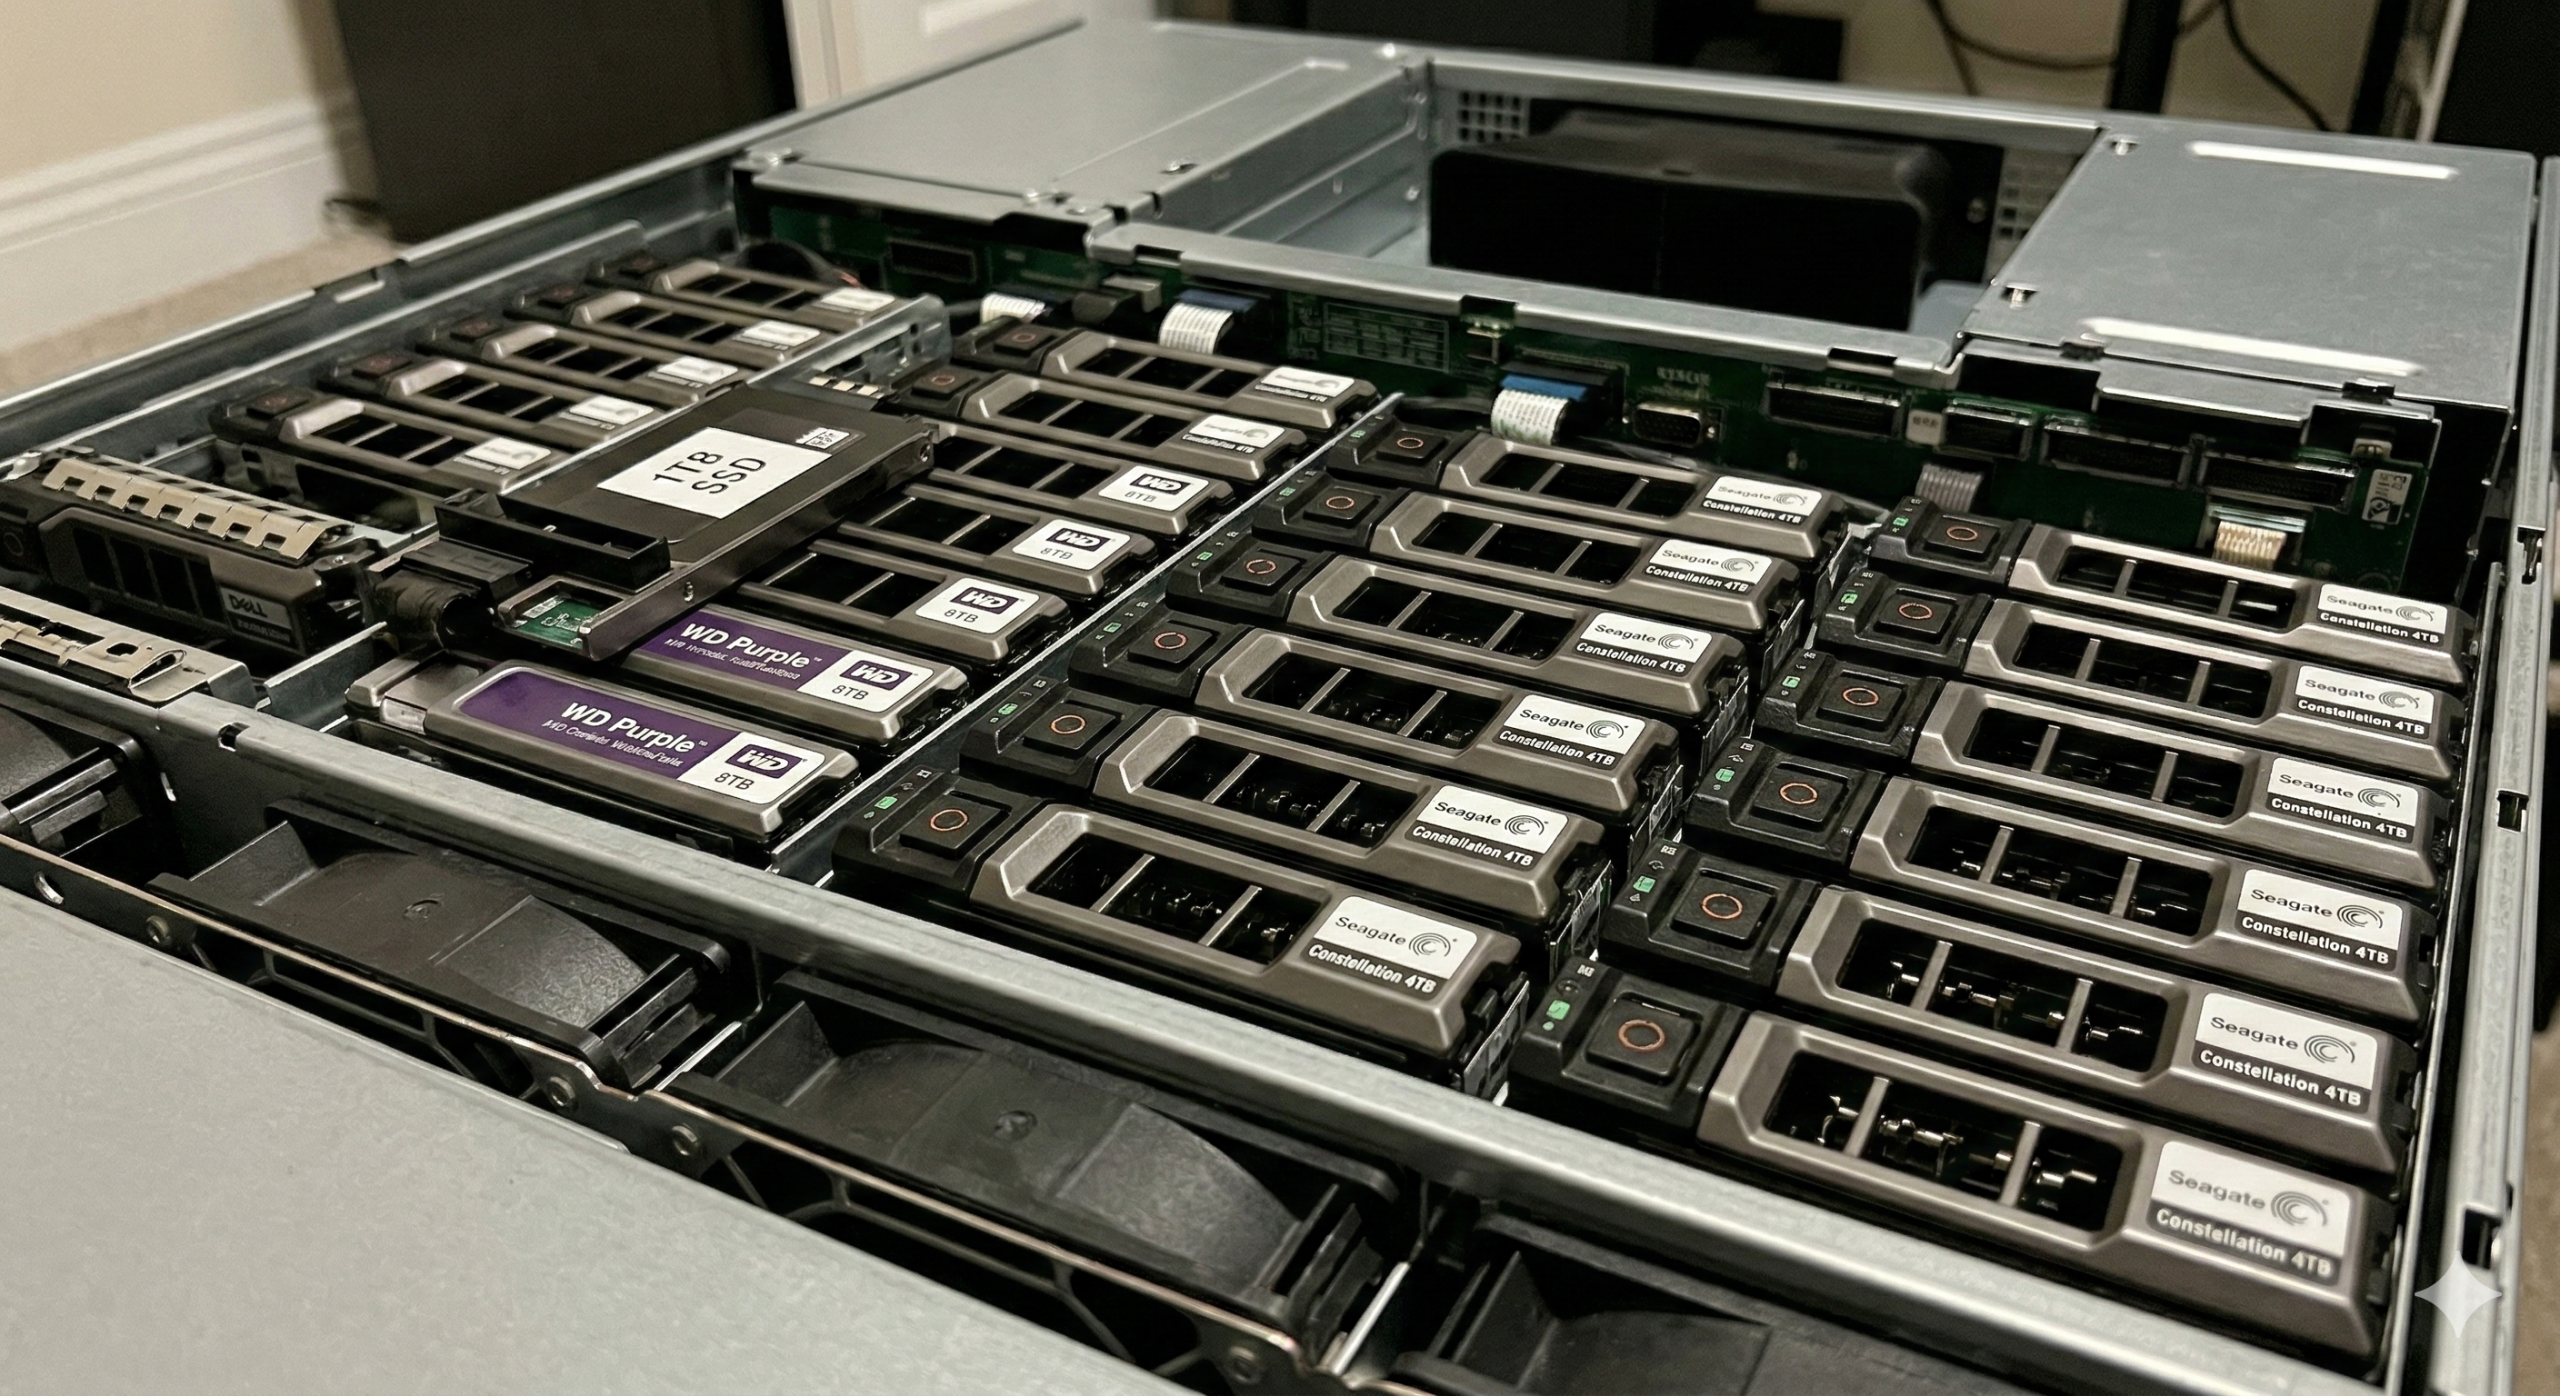
Actualmente, lilxeon se sustenta sobre tres sistemas de almacenamiento físico diferenciados:
A. EL TIER DE VELOCIDAD (SISTEMA Y CACHÉ)
-
Hardware: 1x SSD de 1TB (Consumer/Pro grade).
-
Propósito: Aloja el sistema operativo Proxmox VE, las particiones de swap y los discos virtuales de las VMs más críticas que requieren IOPS altos (como la base de datos centralizada). Además, actúa como caché de lectura/escritura para ciertas operaciones temporales.
B. EL TIER DE PRODUCCIÓN SQL Y WEB (RAID10 SAS)
-
Hardware: 12x Discos SAS HDD Seagate Constellation de 4TB cada uno.
-
Configuración: RAID10.
-
Lógica: Elegimos SAS por su fiabilidad en entornos 24/7 y RAID10 porque buscábamos el mejor rendimiento de escritura y lectura aleatoria posible para las bases de datos MariaDB y los archivos de los sitios web. No queríamos penalizaciones de paridad (como en RAID5/6) al guardar cambios pesados en los editores visuales.
-
Capacidad Útil: Aproximadamente 24TB de puro rendimiento y redundancia (tolerancia al fallo de un disco por pareja de mirror).
C. EL TIER DE REPOSITORIO Y MULTIMEDIA (RAID5 WD PURPLE)
-
Hardware: 4x Discos WD Purple de 8TB cada uno.
-
Configuración: RAID5.
-
Lógica: Aquí prima la capacidad bruta sobre la velocidad de escritura aleatoria. Los WD Purple están diseñados para escritura secuencial continua. Usamos este Tier para la biblioteca multimedia de Jellyfin, descargas P2P, indexadores y, crucialmente, como primer destino de los backups internos.
-
Capacidad Útil: Aproximadamente 24TB de almacenamiento masivo.
3. ARQUITECTURA DE RED Y SEGURIDAD PERIMETRAL
La virtualización no sirve de nada si no se acompaña de una red virtualizada inteligente. No queríamos que un contenedor LXC web comprometido pudiera hacer ping a la red de gestión del hipervisor.
Virtualización de Red (Bridges)
Hemos segmentado la red física en múltiples puentes virtuales (Bridges en Proxmox):
| Bridge | Segmento | Gateway | Propósito |
| vmbr0 | 10.0.0.0/24 |
10.0.0.1 |
Producción: Tráfico web, bases de datos y servicios core. |
| vmbr10 | 10.10.0.0/24 |
10.10.0.1 |
Laboratorio (vlab): Aislamiento total para pruebas. |
El Entry Point: NginxProxy + ModSecurity WAF
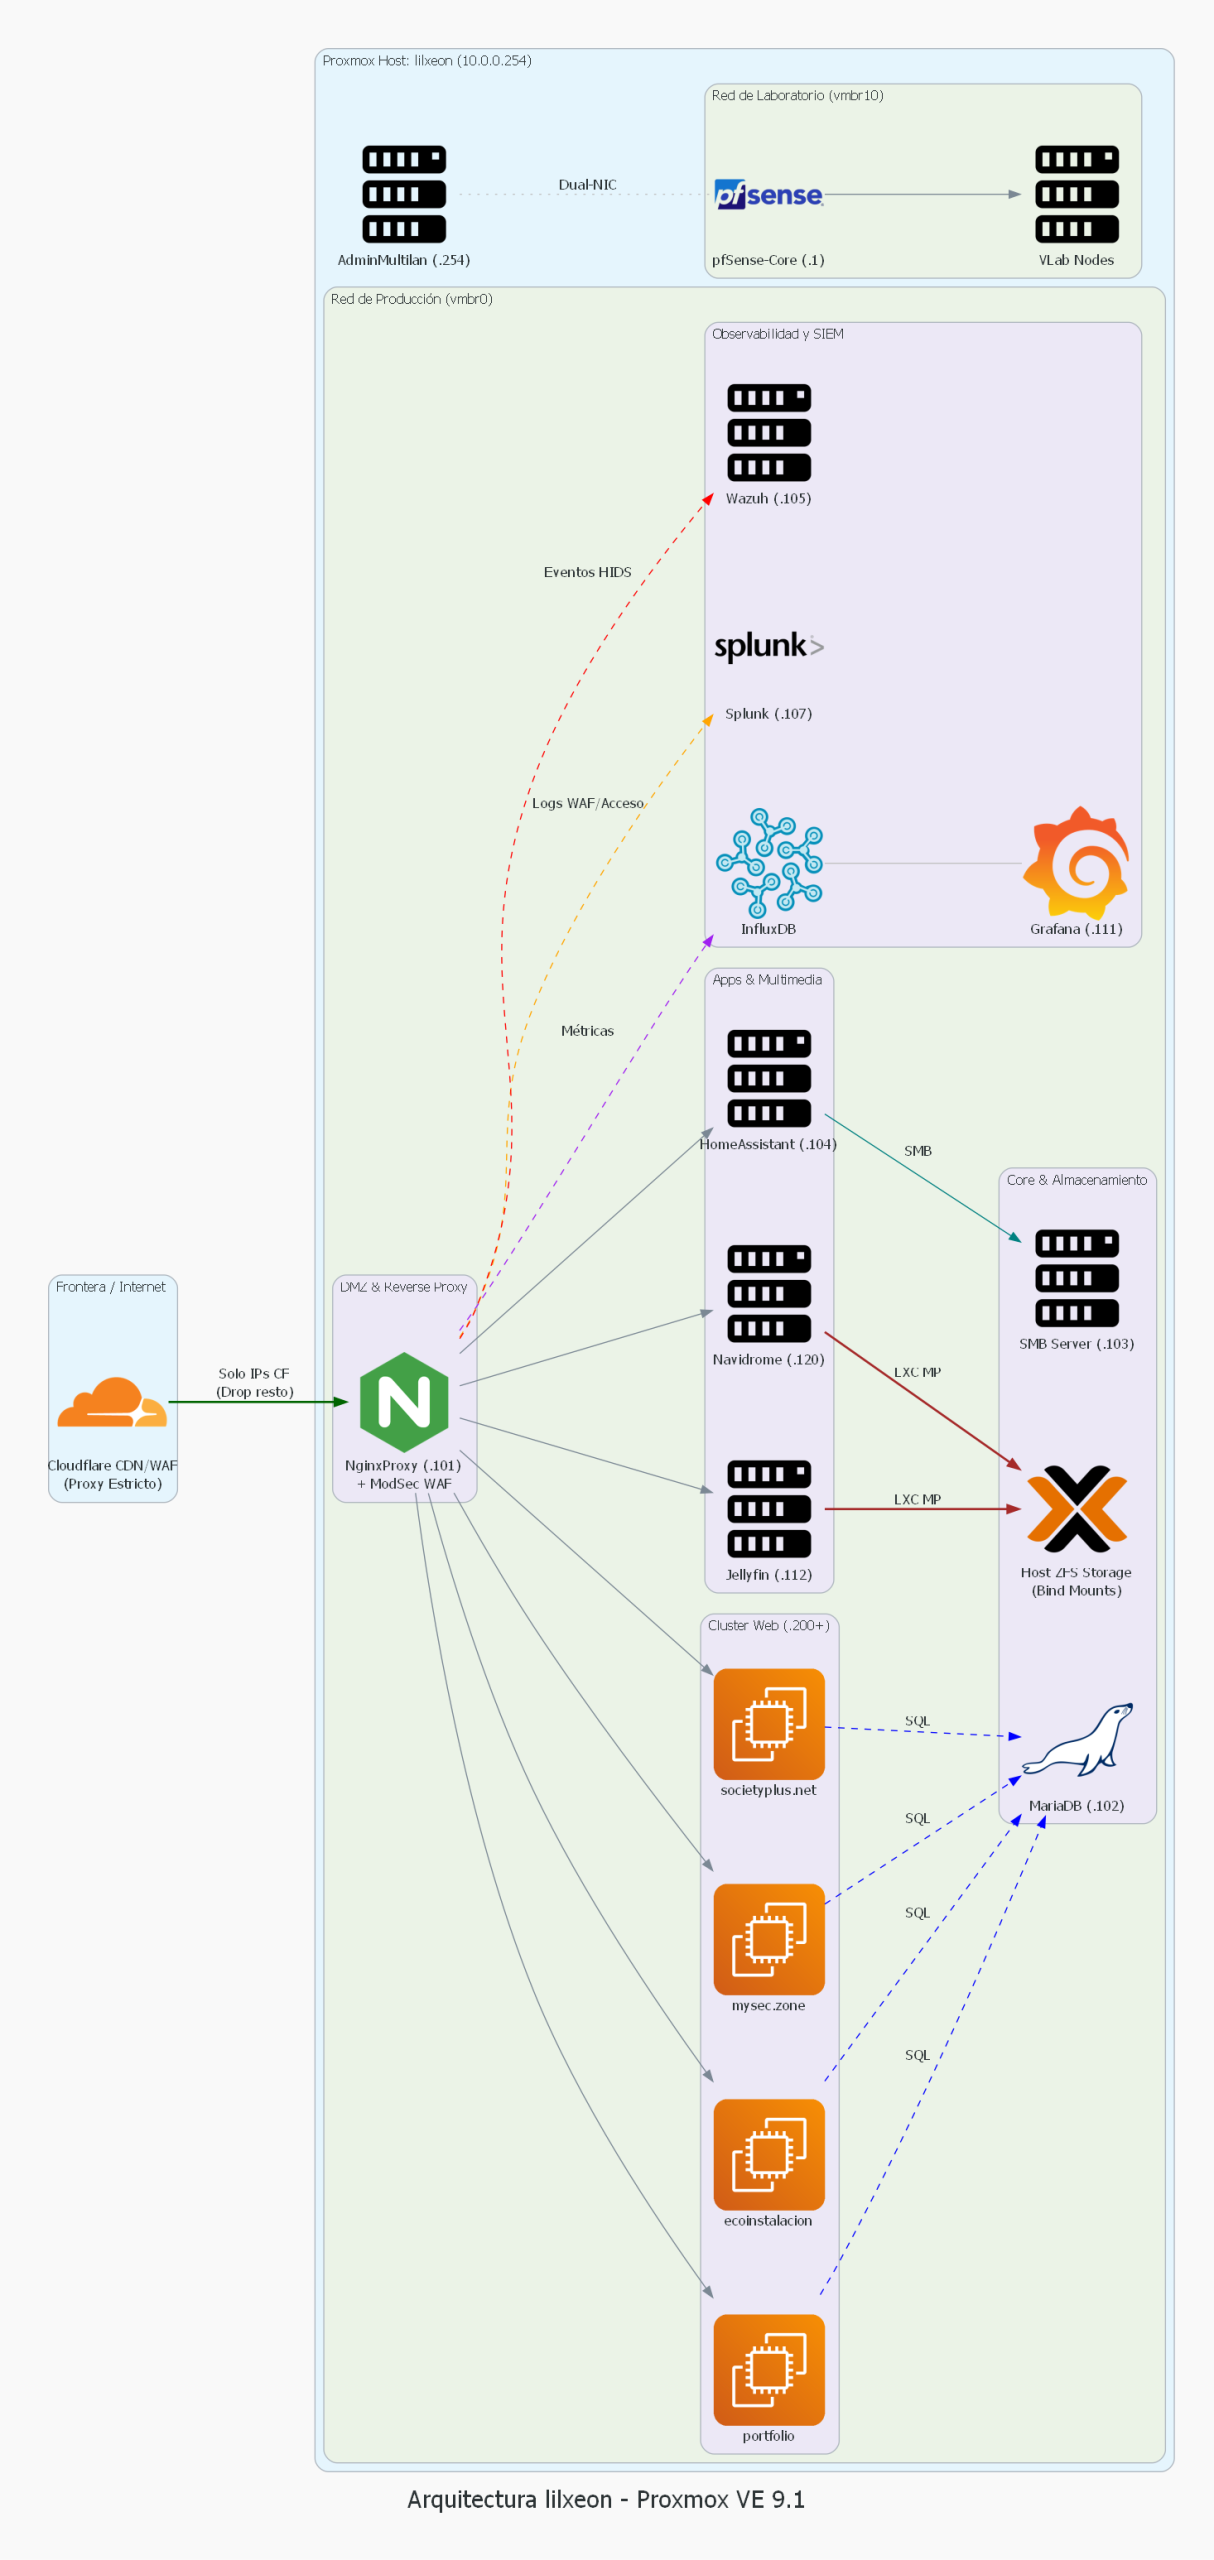
Todo el tráfico web entrante (puertos 80/443) desde Cloudflare muere en el contenedor LXC NginxProxy (.101). Este no es un simple proxy inverso; es nuestro centinela perimetral.
Fallback y ModSecurity
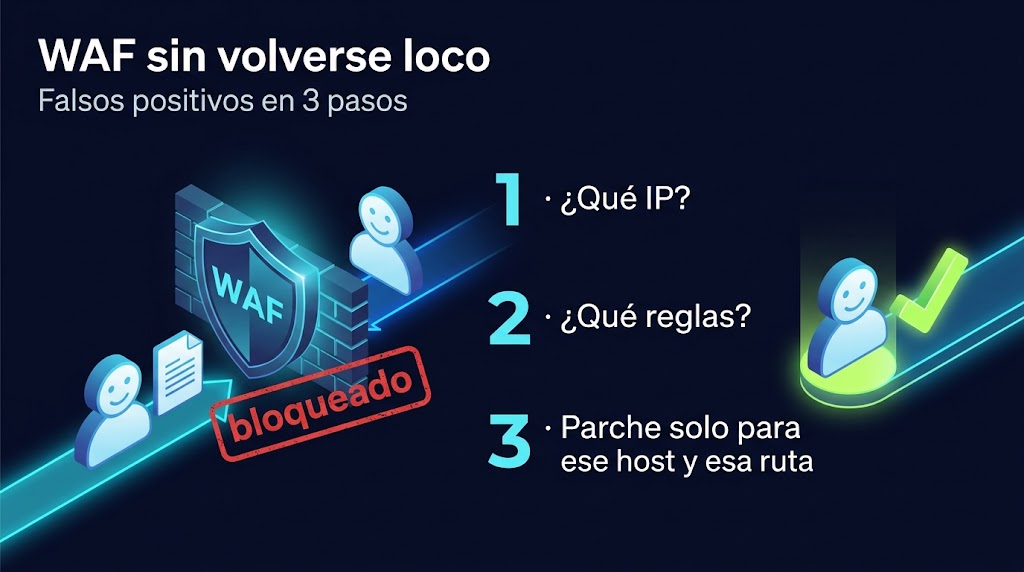
Hemos integrado ModSecurity, un Firewall de Aplicaciones Web (WAF) de grado empresarial. Analiza cada petición en busca de patrones de ataque conocidos (SQLi, XSS, etc.).
Como aprendimos por las malas, editores visuales pesados como Oxygen Builder en WordPress envían peticiones POST masivas con miles de argumentos al guardar. Esto hacía saltar el WAF por defecto, bloqueando la edición. Tuvimos que aplicar políticas de exclusión específicas y sincronizar los límites: si el WAF deja pasar 50,000 argumentos (SecArgumentsLimit), PHP en el backend debe estar configurado para aceptarlos (max_input_vars).
4. DESGLOSE DEL CLUSTER WEB Y MICROSERVICIOS
Aquí es donde la simetría de lilxeon brilla. Hemos organizado los servicios secuencialmente por IPs espejo con sus VMIDs.
INFRAESTRUCTURA CORE Y MULTIMEDIA (vmbr0)
-
100 (Transmission): Gestión P2P aislada.
-
101 (NginxProxy): El centinela ModSecurity.
-
102 (MariaDB): Base de datos centralizada. Todos los nodos web apuntan aquí para simplificar backups y optimización de motor SQL.
-
103 (SMBServer): NAS interno en RAID5. Punto de montaje central para backups y multimedia.
-
105 (Wazuh): Nuestro SIEM centralizado para recepción de logs de seguridad.
-
107 (Splunk): Plataforma de analítica de logs profunda.
-
111 (monitoring-stack): InfluxDB, Grafana y Prometheus para observabilidad métrica.
-
112 (Jellyfin): Servidor multimedia apuntando al Tier RAID5.
-
113 (Wireguard): VPN de acceso administrativo seguro.
CLUSTER WEB HOSTING (vmbr0)
Un esquema de IPs espejo: el rango .200+ mapea directamente los últimos dígitos del VMID (9xx -> .2xx).
-
900 (www.societyplus.net – .200): Web corporativa principal.
-
904 (ecoinstalacion.com – .204): Sitio web de cliente.
-
906 (amperium.es – .206): Proyecto e-commerce.
-
911 (CENSORED – .211): Agencia de CENSORED con altos requerimientos WAF/PHP por Oxygen Builder.
-
(Nodos .201 a .210): Varios sitios de porfolio, APIs y entornos de staging aislados.
5. INTERCONEXIÓN DE SERVICIOS Y FLUJO DE DATOS
Nada funciona de forma aislada en lilxeon. La verdadera potencia de esta arquitectura radica en cómo se comunican los contenedores.
El Triángulo del Rendimiento Web
Consideremos una petición a CENSORED:
-
NginxProxy (.101) recibe la petición HTTPS (terminación SSL), ModSecurity la valida.
-
Si la petición es válida, se hace proxy_pass a la IP interna del backend (.211).
-
El LXC .211 (Apache+PHP) procesa el código. Al necesitar datos, se conecta internamente a MariaDB (.102).
-
MariaDB (.102) sirve los datos desde el Tier RAID10 SAS de alto rendimiento.
Flujo de Reporting y Logs
-
El NginxProxy (.101) genera logs de acceso y de seguridad (ModSec blocks).
-
Un agente de Wazuh en el proxy envía estos logs en tiempo real a Wazuh Server (.105) para correlación de alertas.
-
Paralelamente, Splunk Forwarder envía logs a Splunk (.107) para dashboards analíticos.
-
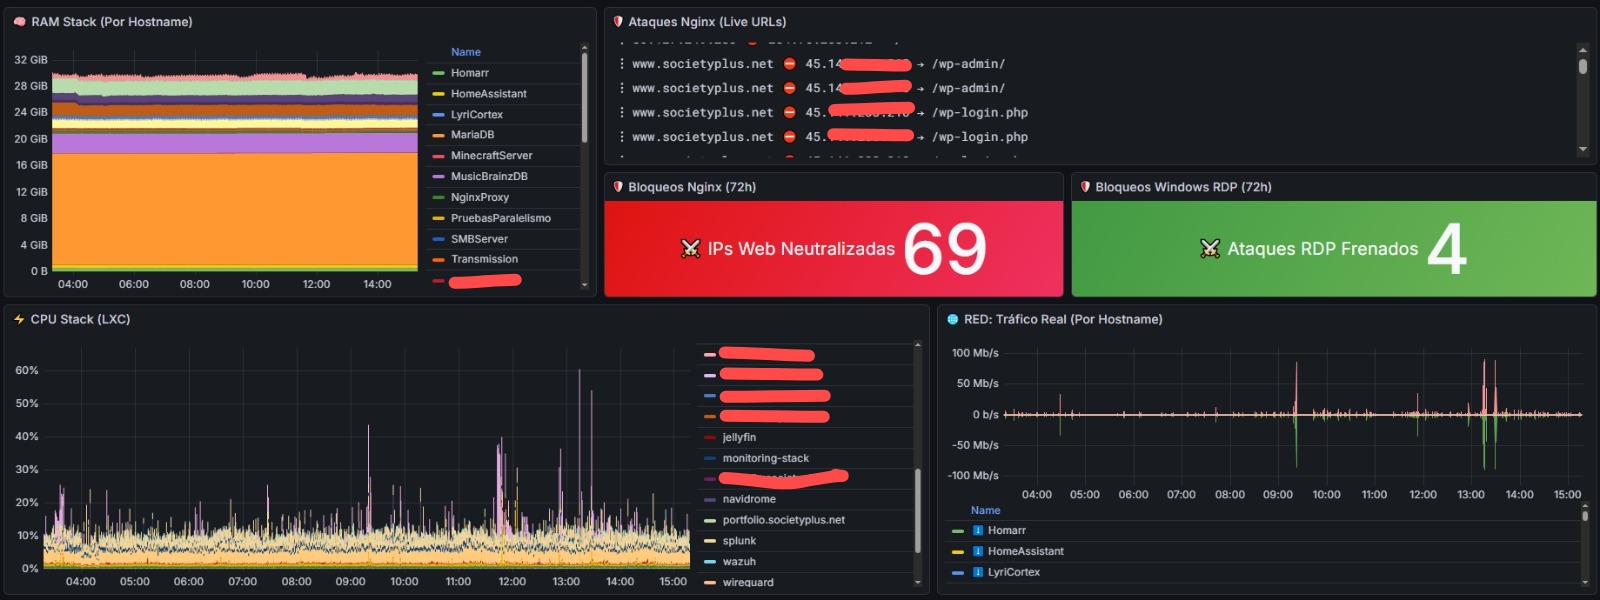
Métricas de CPU/RAM de todos los LXC se envían a monitoring-stack (.111) (InfluxDB) para Grafana.
6. POLÍTICA DE BACKUPS Y PLAN DE CONTINGENCIA (ROLLBACKS)
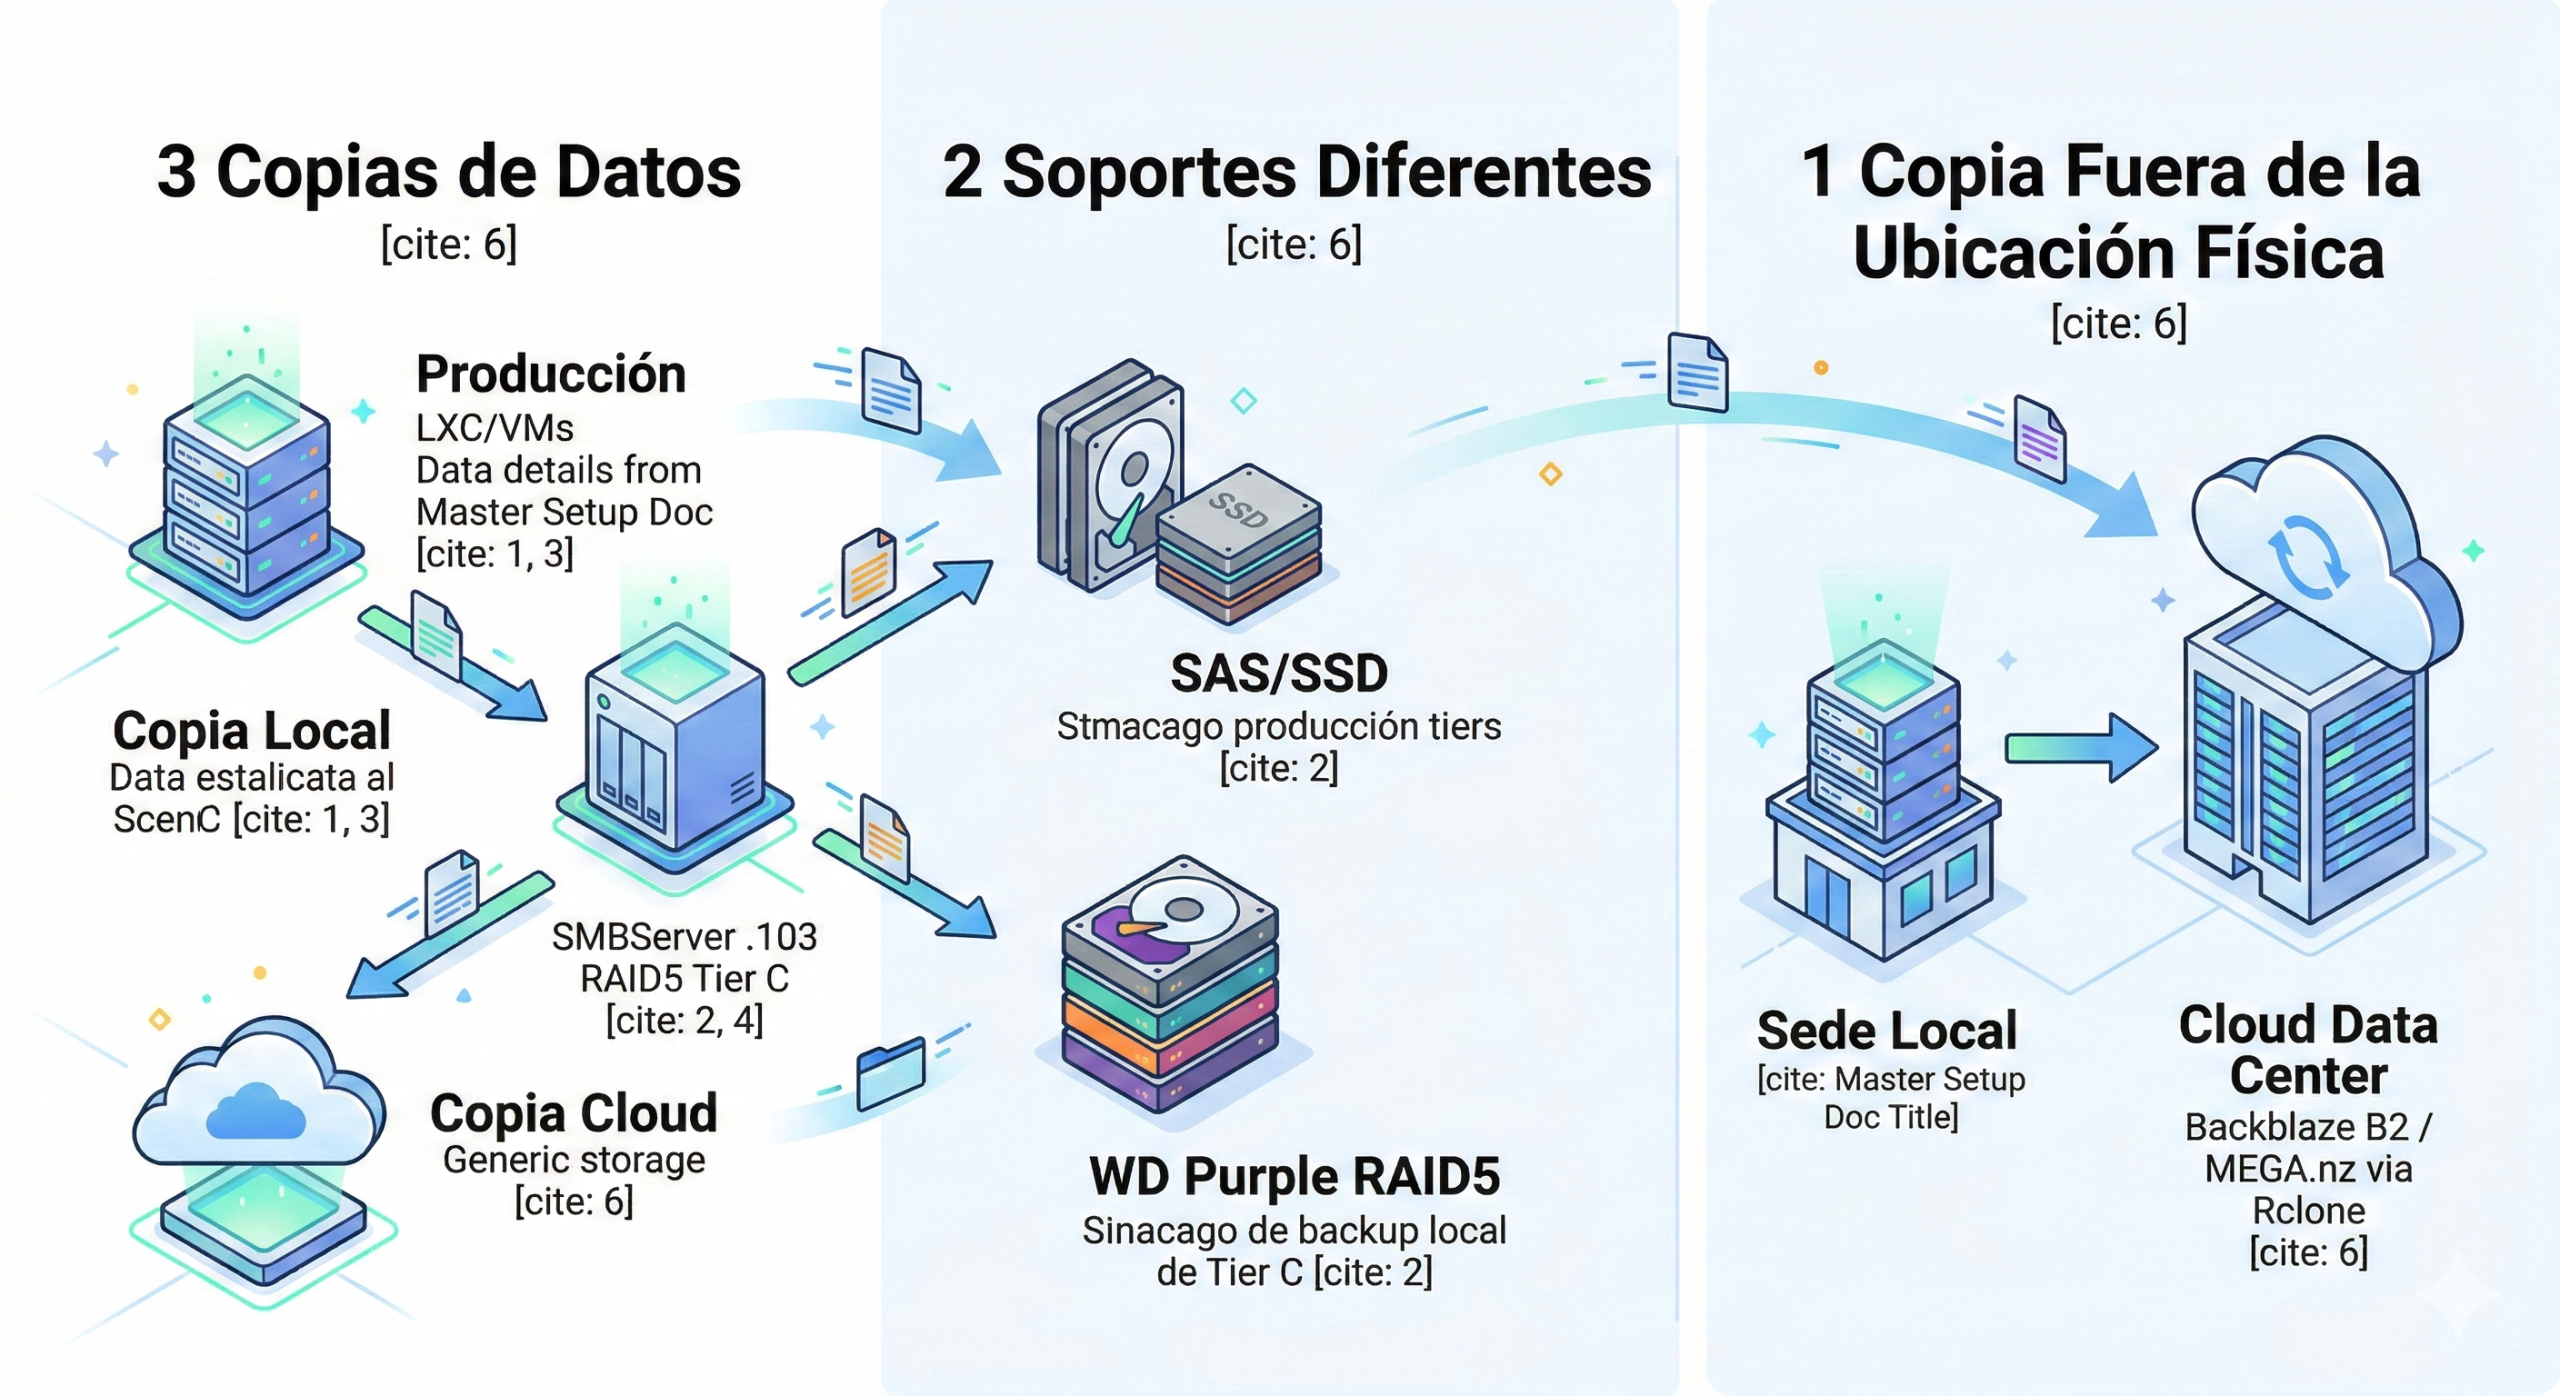
Ha una lección aprendida con dolor: «Un backup no probado es un backup que no existe». En lilxeon implementamos una estrategia de copias de seguridad multicapa con capacidad de Rollback casi instantáneo.
CAPA 1: Snapshots de Proxmox (El Rollback Inmediato)
-
Frecuencia: Antes de cualquier actualización mayor de SO, cambio de configuración crítica en un nodo web o despliegue de código arriesgado.
-
Lógica: Proxmox nos permite congelar el estado del disco virtual de un LXC/VM en segundos.
-
Rollback: Si la actualización rompe algo, el Rollback al estado anterior tarda menos de un minuto. Es nuestra primera línea de defensa contra errores humanos o bugs de software.
CAPA 2: Backups Programados Centralizados (Proxmox Backup Server)
-
Frecuencia: Diaria/Semanal (retención de 30 días).
-
Destino: Un datastore montado por SMB desde el Tier RAID5 (SMBServer .103).
-
Lógica: Usamos Proxmox Backup Server para copias incrementales dedupulicadas. Si un contenedor web entero se corrompe o borra, podemos restaurarlo completamente a partir de la copia de la noche anterior en cuestión de minutos.
CAPA 3: Backups de Base de Datos y Archivos Críticos (Nivel App)
-
Frecuencia: Cada 6 horas (retención de 7 días).
-
Destino: Montaje SMB local y sincronización Cloud (Backblaze B2 mediante Rclone).
-
Lógica: Un script automatizado en el nodo MariaDB genera volcados SQL granulares de cada base de datos. Esto nos permite restaurar un sitio web específico (base de datos + carpeta
wp-contentmontada secuencialmente) sin tener que restaurar todo el contenedor LXC, lo cual es mucho más eficiente para incidencias menores (borrado accidental de un post, por ejemplo).
7. REPORTING, OBSERVABILIDAD Y DEFENSA ACTIVA
Hablemos de cómo monitorizamos todo este «monstruo». No sirve de nada tener la mejor seguridad si no sabes que te están atacando.
El Dashboard de Seguridad Centralizado (Wazuh + Grafana)
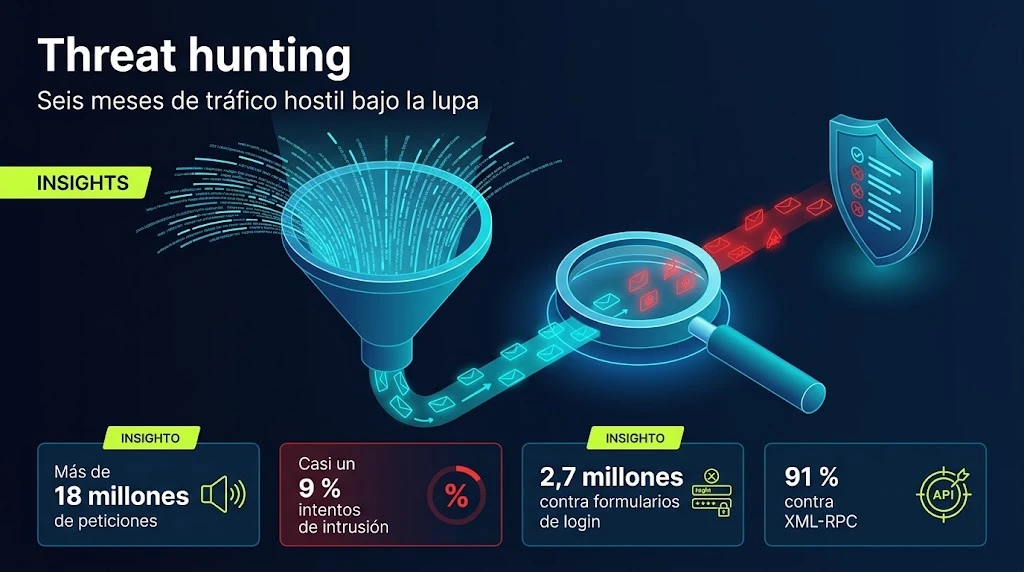
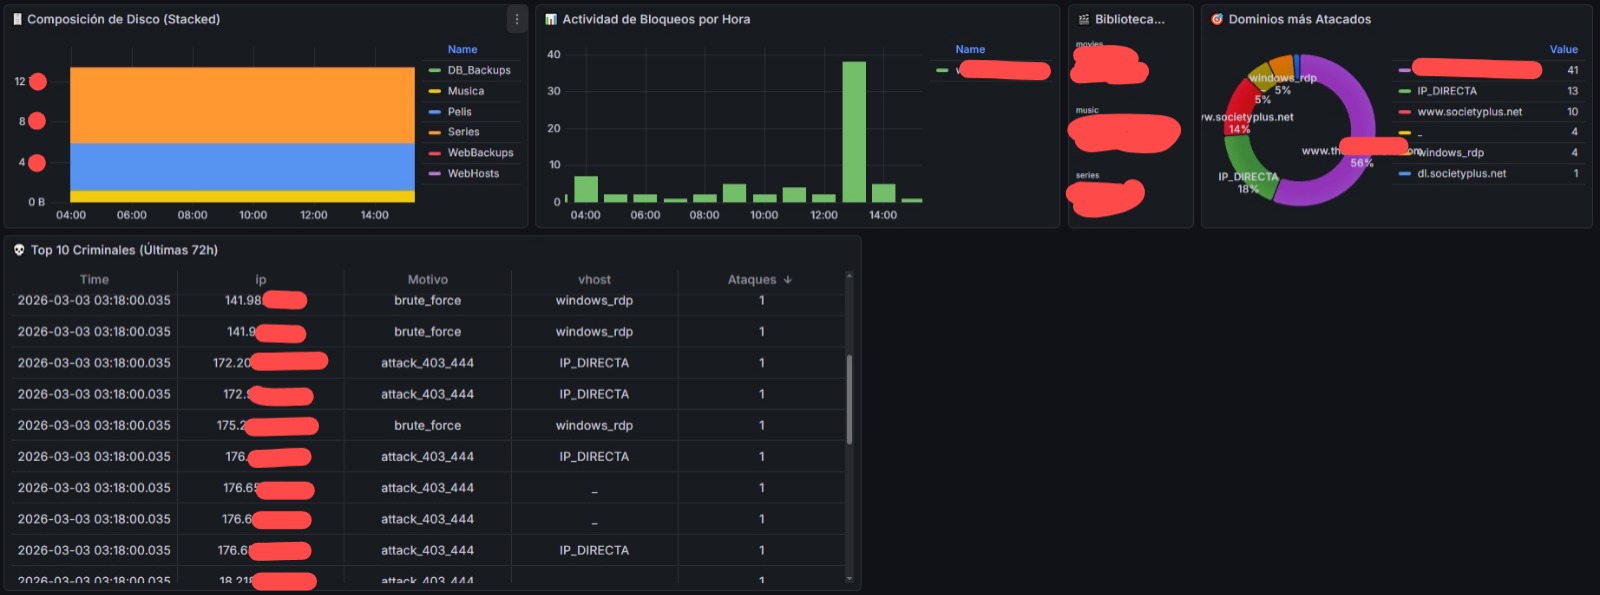
Nuestros dashboards (como se aprecia en las capturas adjuntas) nos dan una visibilidad forense total del tráfico web:
-
Ataques Nginx (Live URLs): Vemos en tiempo real intentos de escaneo a
xmlrpc.php(típico de WordPress) o búsquedas de archivos.env. -
IPs Web Neutralizadas (Últimas 72h): Un contador global de cuántas IPs han sido baneadas por el WAF ModSecurity o por nuestro sistema de defensa activa.
-
Top Dminios más Atacados: Un gráfico circular que nos dice qué sitio web está recibiendo más «cariño» de los bots.
El Portero: Defensa Activa Automática
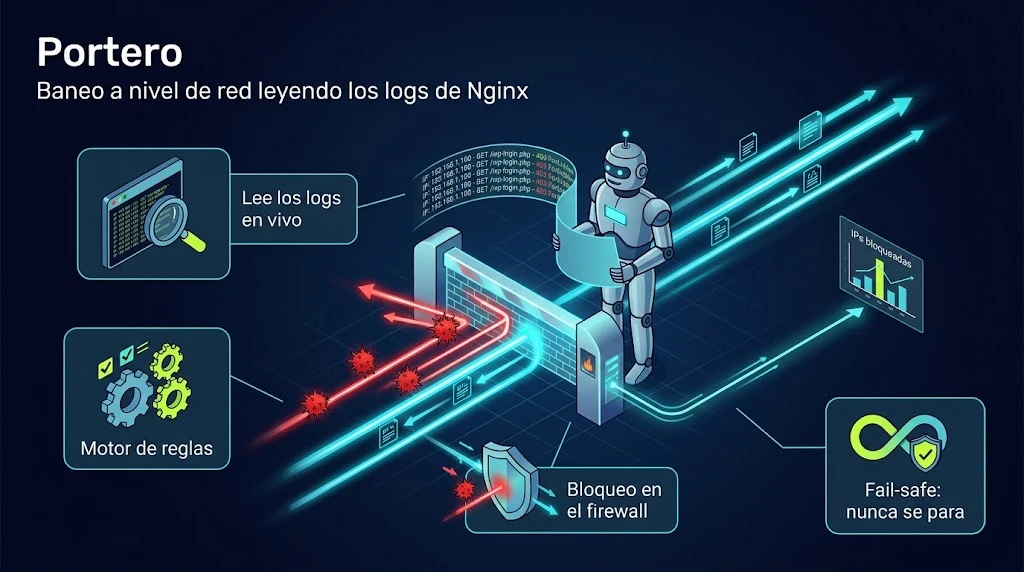
Como complemento a ModSecurity, hemos desarrollado Portero, un script en Python que actúa como un IDS/IPS local.
-
Funcionamiento: Analiza el
access.logde NginxProxy cada minuto buscando ratios de error 4xx/5xx elevados desde una misma IP o patrones de fuzzing (escaneo agresivo de directorios). -
Acción: Si una IP cruza el umbral de errores establecido, el script la añade automáticamente a un IPSet de Kernel (firewall) en el proxy.
-
Resultado: El tráfico de esa IP se bloquea a nivel de red antes incluso de que la petición llegue a procesarse por Nginx. Esto reduce drásticamente la carga de CPU durante ataques de escaneo. El reporte de «Top 10 Criminales» en nuestros dashboards se alimenta directamente de la base de datos de bloqueos de Portero.
8. CONCLUSIONES Y BALANCE AUTOCRÍTICO
Al mirar atrás, a la infraestructura caótica de hace dos años, el salto cualitativo es innegable. Hemos aprendido…, perdón, hemos aprendido mucho en este proceso de centralización y securización.
La arquitectura actual de lilxeon nos ofrece:
-
Centralización Total: Todo el hierro se gestiona desde un único panel (Proxmox), simplificando operaciones y backups.
-
Seguridad Multicapa: ModSecurity WAF + Portero Active Defense + Redes Segmentadas + Snapshots.
-
Observabilidad Granular: Sabemos qué CPU está usando
MariaDBo qué URL está siendo atacada ensocietyplus.neten segundos.
Puntos de Mejora (El camino por recorrer)
Pero no somos autocomplacientes. El sistema perfecto no existe:
-
SPOF (Single Point of Failure): Aunque el almacenamiento tiene RAID, el propio host físico
lilxeon(.254) es un punto único de fallo. Si el hardware del servidor Dell muere, todo el cluster web cae. La solución a medio plazo es crear un cluster de alta disponibilidad (HA) con al menos otro host físico y almacenamiento compartido (Ceph/ZFS over network), pero eso requiere un presupuesto significativo de hardware SAS/NVMe. -
Complejidad de Mantenimiento: La cadena ModSecurity -> Nginx -> PHP -> MariaDB es potente pero compleja de diagnosticar cuando algo falla internamente. Requerimos personal técnico muy cualificado para mantener la afinación de todos los componentes.
En resumen, lilxeon ha pasado de ser un laboratorio inestable a una plataforma de producción semi-industrial robusta y segura. Seguiremos iterando y afinando, pero la base arquitectónica es sólida y está preparada para los retos de los próximos años.