Resumen: en septiembre de 2026 crucé seis meses de tráfico de mi plataforma web para responder algo que no tenía respuesta fiable: ¿qué parte de lo que llega a mis servidores es realmente hostil? El resultado fue un análisis de más de 18 millones de peticiones, una lista de bloqueo permanente construida con criterio (no a base de reacciones puntuales), ajustes para no penalizar a los buscadores legítimos, y un bloqueo unificado que se audita solo cada día en todo el parque.
El problema: bloqueos reactivos, visión fragmentada
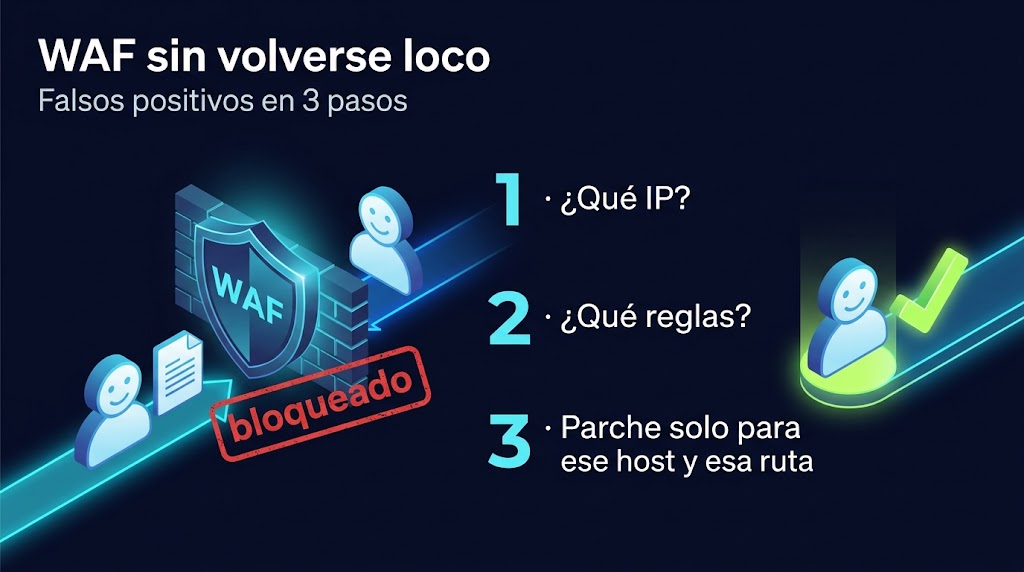
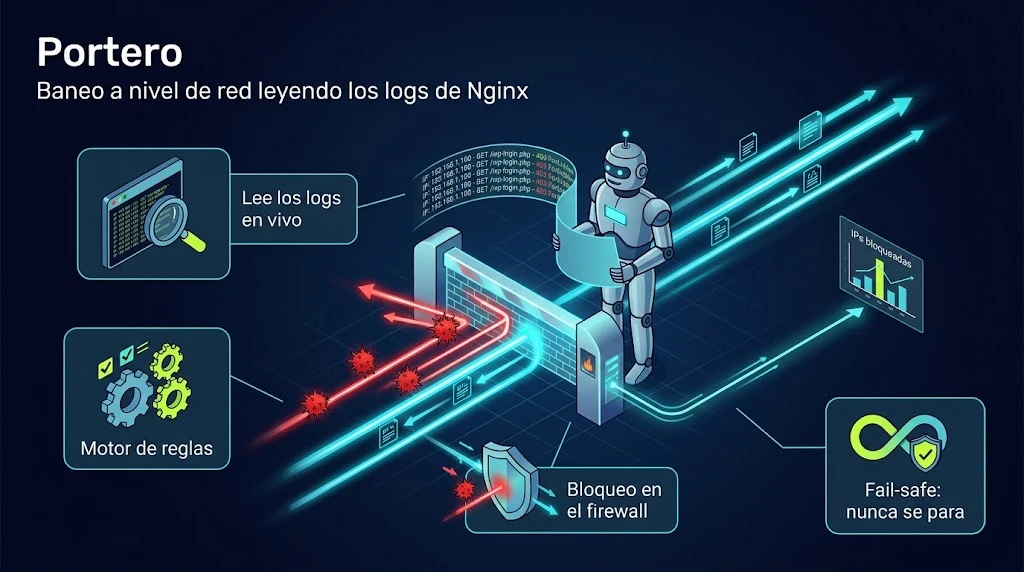
Defiendo un clúster de webs WordPress (algunas propias, otras de clientes) con varias capas: Cloudflare por delante, un WAF con ModSecurity y el ruleset de OWASP en el proxy de entrada, y un demonio propio que banea IPs por comportamiento a nivel de red. Funciona, pero de forma reactiva: cada capa apaga sus propios incendios sin que nadie mire el conjunto. Tenía la sospecha de estar baneando cosas que no debía y dejando pasar patrones que sí merecían un bloqueo permanente, pero sin datos de fondo era solo eso, una sospecha. Planteé el ejercicio completo: coger lo registrado en los últimos seis meses, cruzarlo, y sacar de ahí una lista de bloqueo duradera en vez de baneos temporales que expiran y vuelven a empezar.
Metodología: cruzar fuentes hasta dar con la única fiable
Tengo varias fuentes de telemetría de seguridad y no todas cubren lo mismo. Antes de sacar una sola conclusión tuve que mapear qué cubría cada una:
| Fuente | Cobertura real | Qué aporta |
|---|---|---|
| Logs centralizados (Splunk) | 6 meses completos | URI, código, user-agent, sitio — la única con el histórico entero |
| Auditoría del WAF | 6 meses | Qué reglas saltaron, por IP y sitio |
| Borde de Cloudflare | Desde finales de abril | Bloqueos y retos antes del origen |
| Series temporales (InfluxDB/Grafana) | Un tramo infravalorado | Volumen y baneos automáticos |
| Logs recientes (Loki) | Un día al empezar | Caza en caliente, no histórico |
El hallazgo más incómodo de esta parte no fue de seguridad, fue de instrumentación: la serie temporal que uso para gráficas llevaba meses infravalorando el tráfico real porque una de las etiquetas (la IP) había tocado techo de cardinalidad y cada IP nueva se perdía en silencio. Lo arreglé, pero cualquier gráfica de ese periodo concreto mentía por defecto. Lección: cuando una fuente «no cuadra» con otra, sospecha primero de la instrumentación antes que del dato. Con eso claro, apoyé el análisis de volumen en la única fuente con el rango completo, y usé el resto para contrastar y enriquecer (ASN, país, qué reglas exactas saltaron).
Qué salió: cifras que no esperaba
Sobre el total de peticiones en seis meses, casi un 9% llevaba firma clara de intento de intrusión (rutas típicas de fugas de credenciales, webshells conocidos, explotación de utilidades de testing expuestas) y un 14,5% acabó en error 4xx/5xx. Una de cada once peticiones que llegan a mi origen es alguien probando suerte con un backdoor o un fichero de configuración filtrado — y eso es después de que Cloudflare ya haya filtrado por delante.
La campaña dominante no era ruido disperso: un barrido sostenido de webshells y de un conocido vector de ejecución remota vía herramientas de testing, lanzado desde salidas de proveedores VPN/VPS comerciales, con user-agent vacío casi siempre. Más de cien direcciones distintas con al menos mil peticiones cada una, sumando cerca de un millón de peticiones en total, activa los seis meses y creciendo mes a mes. Lo interesante — y lo que la hacía peligrosa — es que al pedir rutas que no existen, el WAF nunca la veía: son 404 limpios, no payloads que disparen una regla. Solo el demonio de bloqueo por comportamiento la detectaba, y la baneaba temporalmente para que volviera a las 24 horas con otra IP del mismo bloque.
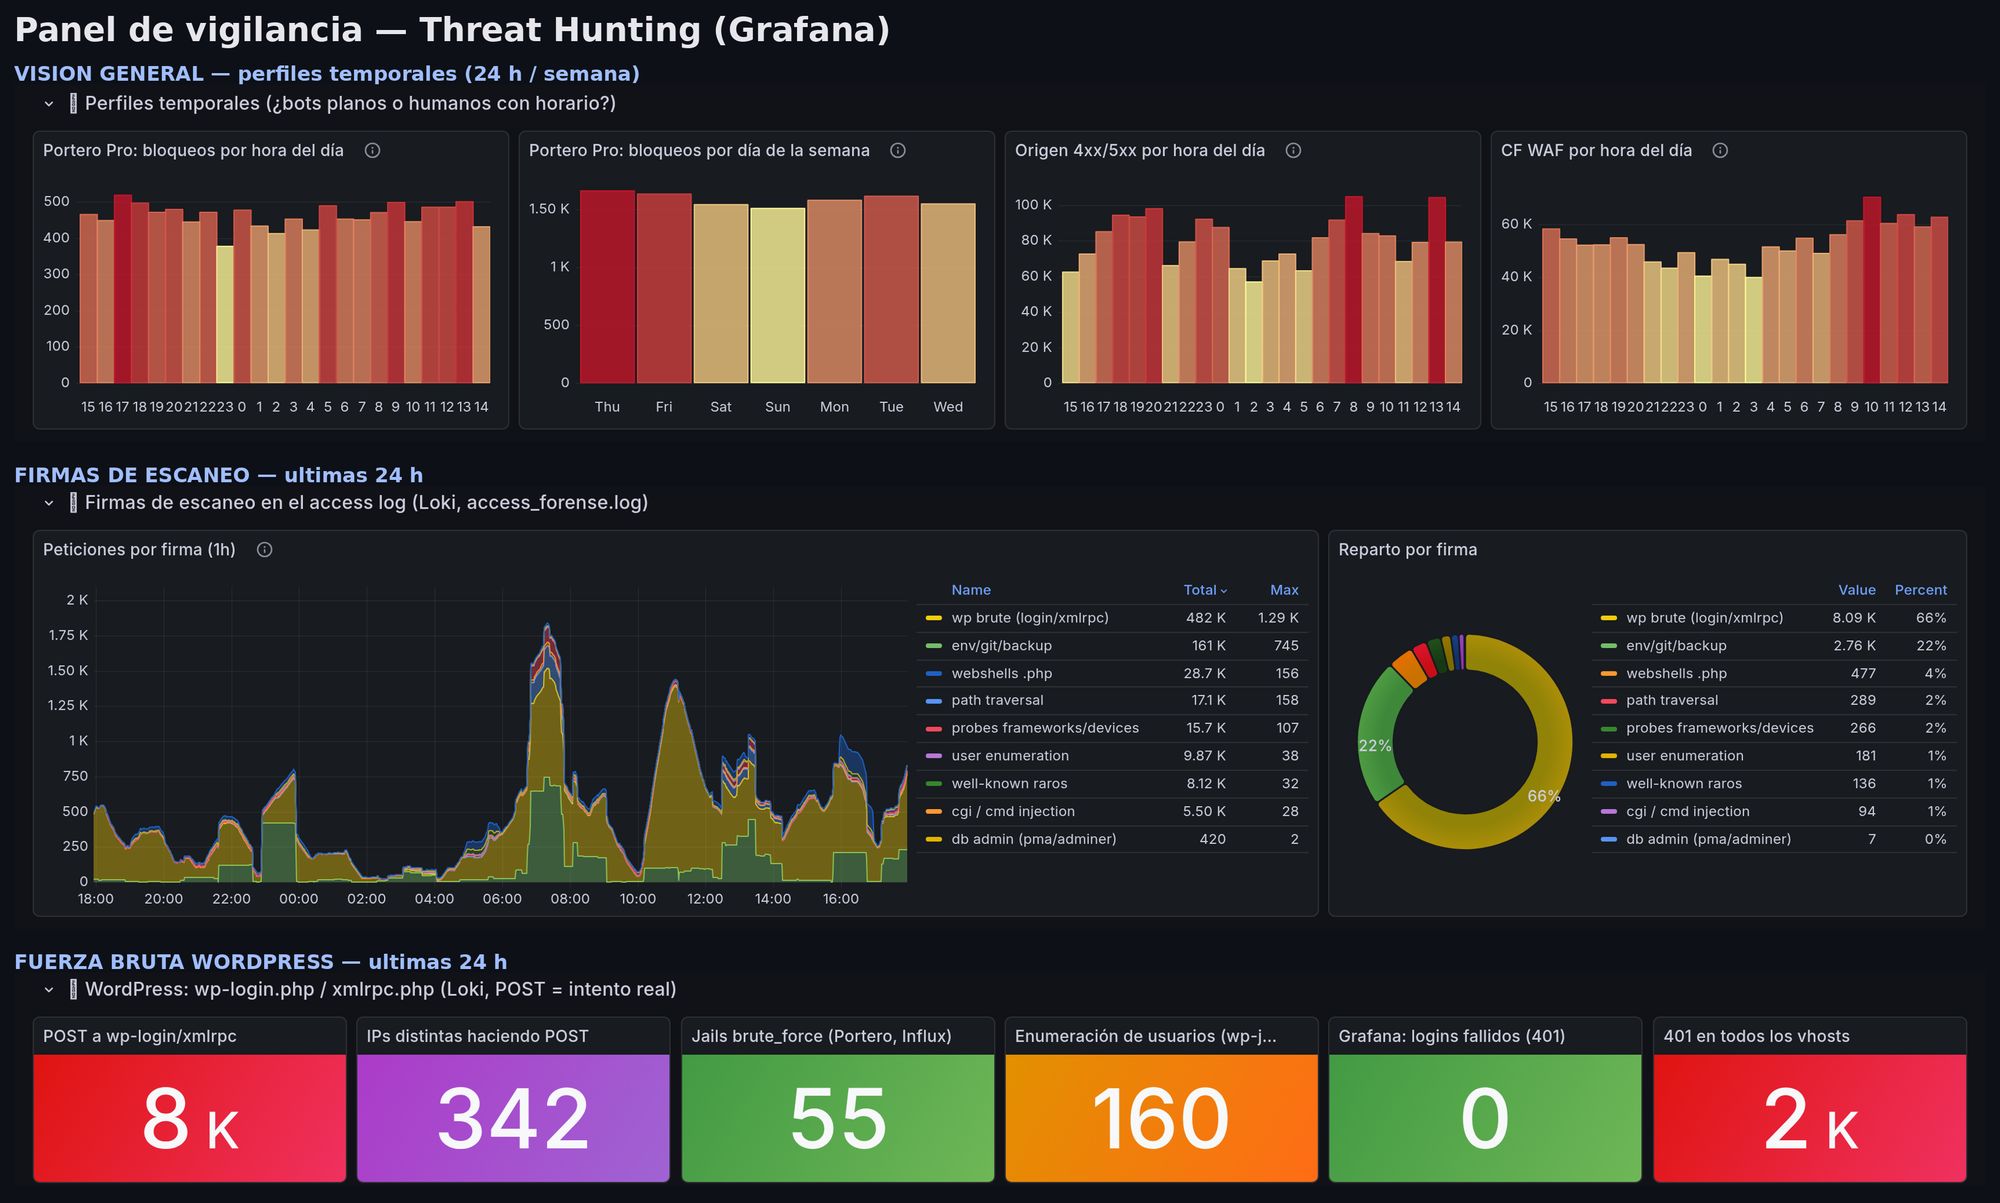
La fuerza bruta contra WordPress fue el segundo bloque grande: cerca de 2,7 millones de peticiones POST contra formularios de login en seis meses, con un 91% dirigido a la interfaz XML-RPC en vez del formulario de login normal — el vector clásico para amplificar intentos de credenciales sin disparar los mismos contadores que un login fallido visible. Un tercer patrón, más silencioso: el escaneo de ficheros de configuración y credenciales filtradas se triplicó en el último mes del periodo, sin que ninguna alerta puntual lo hubiera marcado como tendencia. Y el ritmo, por curiosidad, es prácticamente plano las 24 horas y los 7 días: no hay ventana tranquila, solo sube el porcentaje hostil de madrugada porque baja el tráfico humano.
Medidas que apliqué
- Lista de bloqueo permanente por niveles. Separé lo que tenía firma clara y reincidencia en varios meses (bloqueo permanente, algo más de un centenar de entradas entre rangos y direcciones sueltas) de lo que tenía firma parecida pero volumen bajo o eran máquinas cloud efímeras que rotan de cliente legítimo con frecuencia — eso último lo dejé fuera a propósito: el riesgo de bloquear tráfico legítimo futuro superaba el beneficio de banear algo que cambiará de dueño la semana que viene.
- Restricción de XML-RPC. Casi todo el tráfico que se identificaba como parte del ecosistema oficial de WordPress.com/Jetpack en realidad no venía de sus redes reales (user-agent falsificado), así que pasé a servir XML-RPC únicamente a las redes legítimas de ese servicio.
- Lista blanca de buscadores. Al cruzar los baneos automáticos vi que el rastreador de Google (y en menor medida Bing) podía caer en ellos al pedir sitemaps antiguos que ya no existen: un bot legítimo que, visto desde fuera, se comporta como un escáner. Metí sus rangos en lista blanca y dejé de contar los 404 de sitemap/robots como ataque: la corrección más barata y con más impacto de todo el ejercicio.
- Un panel de vigilancia continua: visión general del tráfico hostil, top de atacantes, firmas más comunes, fuerza bruta, capa de Cloudflare y accesos directos por IP sin dominio — para no repetir este ejercicio a mano cada vez.
Un bloqueo que se comprueba solo
Una lista de bloqueo solo sirve si se aplica en todos los sitios. En nginx no basta con tenerla: cada bloque de configuración de sitio tiene que incluir explícitamente el fragmento que corta el tráfico baneado, porque las reglas no se heredan entre bloques. Así que dejé el bloqueo en una única pieza común, incluida desde todos los sitios, y añadí una auditoría automática diaria que recorre la configuración efectiva del proxy y avisa —o corrige y recarga— si algún sitio nuevo se queda sin ella. Que una IP bloqueada lo esté de verdad en todo el parque deja de depender de acordarme de nada.
Resultado y lecciones
Cerré el ejercicio con una lista de bloqueo permanente basada en meses de evidencia (no en el pánico de un pico puntual), un XML-RPC que ya no sirve de vector de fuerza bruta salvo para el servicio legítimo que lo necesita, los buscadores legítimos a salvo de los baneos, un bloqueo auditado a diario en todo el parque y un panel para no repetir el análisis a mano. Como siguiente paso queda decidir si merece la pena banear también el segundo nivel de direcciones (bajo valor, cloud efímero), con un criterio de seguimiento simple para XML-RPC: si en una semana el volumen de intentos no cae de forma drástica, es señal de que algo no está viendo la IP real.
Stack
- nginx + ModSecurity / OWASP CRS
- Cloudflare (WAF de borde)
- Splunk (índice de logs, 6 meses de histórico)
- InfluxDB + Grafana (métricas y panel de vigilancia)
- Loki (logs recientes, caza en caliente)
- ipset / iptables (bloqueo a nivel de red)
- Python (scripts de correlación y generación de la lista de bloqueo)
Relacionado: LILXEON: mi nueva infra con Proxmox, donde cuento cómo está montada la capa de proxy y WAF que protege todo esto.