Resumen: Para vigilar el homelab que sostiene mis proyectos y el hosting de varias webs de clientes, monté dos sistemas de monitorización en paralelo — uno con Grafana, InfluxDB y Loki, otro con Splunk — y me propuse que ambos vieran, más o menos, lo mismo. Por el camino construí una decena de colectores propios en Python y cacé dos bugs de los que no avisan: una métrica de CPU que mentía por un fallo de la API de origen, y un límite escondido de la base de datos que descartaba IPs nuevas sin dar error. Esto es cómo quedó montado y qué aprendí arreglándolo.
El problema: dos herramientas, una sola verdad
Mi homelab corre sobre Proxmox y aloja, además de mis propios servicios, el hosting de un buen número de webs de clientes bajo WordPress. Necesitaba ver, con histórico y en tiempo real, tres cosas a la vez: infraestructura (CPU, RAM, disco, salud de los pools ZFS), seguridad (bloqueos del WAF, fuerza bruta, tráfico filtrado en el borde) y rendimiento de aplicación (latencia real por web, estado de la base de datos).
Ya tenía Grafana sobre InfluxDB funcionando, pero quería aprovechar también Splunk (edición gratuita) para el lado más forense: sus búsquedas ad-hoc son mejores para investigar un incidente concreto a posteriori. El riesgo de mantener dos sistemas es el de siempre — que diverjan, que uno tenga un dato que el otro no, y que acabe confiando a ciegas en el que tenga abierto en ese momento aunque esté equivocado.
Qué construí y por qué
Decidí no elegir una sola herramienta y perseguir paridad en su lugar: que lo importante llegue a los dos sitios. Grafana/InfluxDB/Loki para el día a día —dashboards y alertas nativas—, Splunk como segunda copia de los eventos de seguridad y para búsquedas puntuales.
La ingesta se apoya en varios colectores propios en Python, sin dependencias raras, pensados para no tocar nada de lo que ya funcionaba (nada sustituye una tubería existente, todo se añade en paralelo):
- Un colector de inventario de Proxmox (cada 5 minutos) que escribe estado de nodos, contenedores, pools ZFS, SMART y temperatura a InfluxDB y a Splunk a la vez.
- Un colector de ancho de banda de red (cada minuto), porque la métrica nativa de Proxmox para eso llevaba meses sin escribir.
- Un log adicional de nginx en JSON, en paralelo al
access.lognormal, que captura el tiempo de respuesta real del backend en cada petición: mide la experiencia real del visitante, no solo si nginx respondió rápido. - Un colector de MariaDB que ejecuta
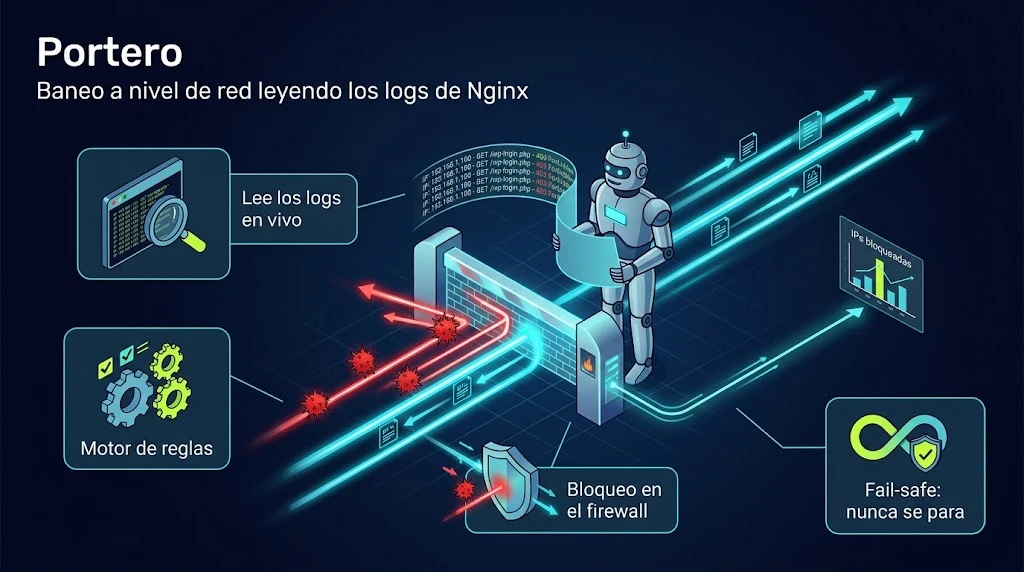
SHOW GLOBAL STATUScada 30 segundos (consultas por segundo, conexiones, ratio de acierto del buffer pool, bloqueos) más el registro de queries lentas activado. - Un colector de eventos de seguridad que sigue el log de auditoría del WAF y el histórico de mi sistema propio de bloqueo automático de IPs (le tengo cariño al nombre: «Portero Pro») y los manda también a ambos sistemas.
Con eso monté una tabla de paridad fuente por fuente —métricas de host, ZFS, nginx (acceso y rendimiento), MariaDB, eventos del WAF, baneos, tráfico en el borde— que dice, para cada una, si vive en Splunk, en Grafana o en ambos. Sirve para ver de un vistazo qué falta y para no dar nada por sabido solo porque aparece en una de las dos pantallas.
Dos bugs que no avisan (y cómo los cacé)
1. La CPU del host en Splunk marcaba siempre 0
El uso de CPU del host en Splunk aparecía fijo en cero, mientras el resto de campos —memoria incluida— eran correctos. La causa: el colector lee el uso de CPU de un endpoint de la API de Proxmox que, en la versión que tengo instalada, devuelve siempre cero para ese campo concreto. La solución: tomar la CPU del host de la métrica nativa que InfluxDB ya recibe del propio Proxmox, que nunca tuvo el problema. Lección: cuando un solo campo de una fuente por lo demás fiable da un valor sospechosamente redondo, hay que mirar de dónde sale ese campo en concreto, no asumir que toda la fuente está bien o mal en bloque.
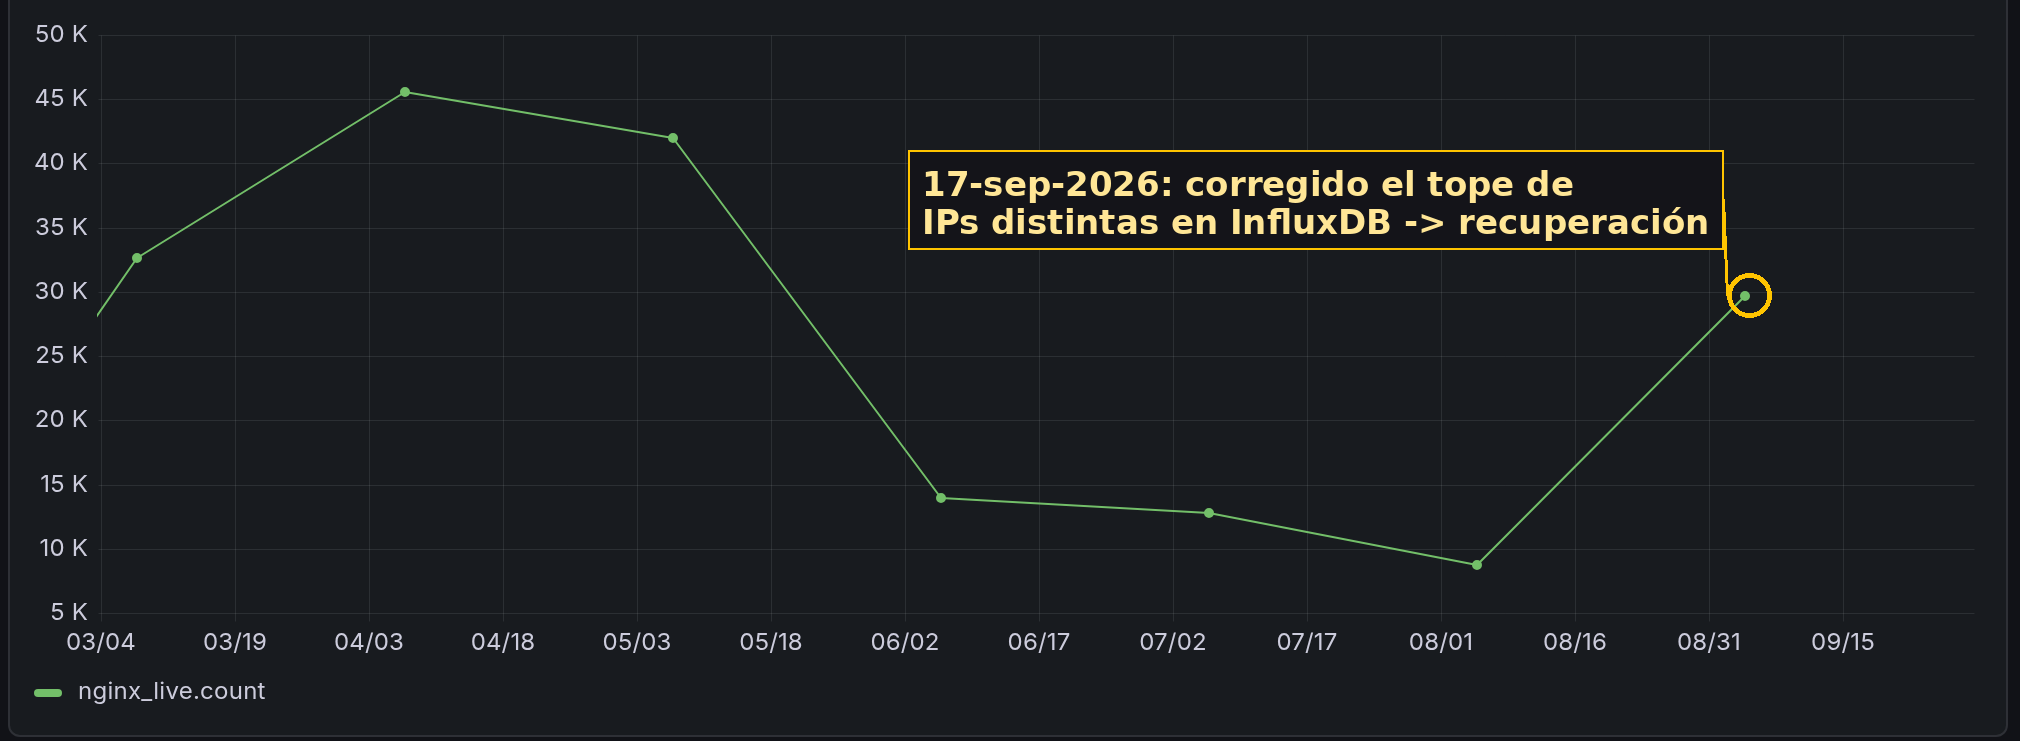
2. InfluxDB perdía IPs nuevas sin avisar
Este fue el más traicionero porque no rompía nada visible: solo sesgaba silenciosamente los paneles. InfluxDB limita cuántos valores distintos puede tener una etiqueta, y uso la IP de origen de cada petición de nginx como etiqueta para poder filtrar por ella. Al acumular decenas de miles de IPs distintas mes a mes, tocó ese techo, y a partir de ahí cada IP nueva que llegaba se rechazaba con un error que no aparece en ningún panel. A partir de ahí, los paneles de «visitantes reales» y «top de tráfico por IP» solo contaban IPs que ya había visto antes de tocar el límite —subestimando cada vez más según pasaba el tiempo—, sin que hubiera ningún error visible en el dashboard: simplemente, los números eran más bajos de lo real. Lo detecté al cruzar el conteo de IPs distintas por mes y ver una caída que no encajaba con ningún cambio real de tráfico. El arreglo fue subir ese límite (y el de series totales por base de datos) en la configuración de InfluxDB; desde entonces la cardinalidad ha subido a varios cientos de miles de series y el motor lo sigue encajando bien. Para analizar el periodo afectado, la fuente fiable pasó a ser Splunk o los logs crudos, que nunca tuvieron ese límite.
Resultado y lecciones
Con la licencia gratuita de Splunk (500 MB/día) el uso real ronda entre 27 y 70 MB/día según el tráfico, con margen de sobra. Tras una limpieza de paneles me quedé con unos 30 dashboards activos en Grafana, y la tabla de paridad confirma cobertura equivalente entre ambos sistemas para casi todas las fuentes: métricas de host y ZFS, rendimiento web, MariaDB, auditoría del WAF y baneos. Loki guarda 182 días de retención en almacenamiento persistente.
Como siguiente paso: activar el performance schema de MariaDB para tener latencia agregada por consulta (requiere reiniciar la base de datos central, así que va en una ventana de mantenimiento) y añadir métricas de sistema tipo node_exporter. La lección general de este proyecto es que un bug de monitorización no avisa como los demás: no tira un servicio, solo hace que confíes en un número que está mal. Los dos de este proyecto solo aparecieron al comparar dos fuentes que deberían decir lo mismo y no lo decían.
| Fuente de datos | Splunk | Grafana (InfluxDB/Loki) | Notas |
|---|---|---|---|
| nginx: acceso completo (sitio, IP, URI, user-agent, referer) | ✅ | ✅ | Retención de 182 días en el lado de logs |
| nginx: acceso «forense» (identificador de incidencia por petición) | ❌ | ✅ | Pendiente decidir si sustituye al log de acceso normal |
| nginx: rendimiento (latencias por sitio) | ✅ | ✅ | Paridad completa |
| WAF: bloqueos | ✅ | ✅ | |
| WAF: auditoría completa (regla exacta por petición) | ✅ | ✅ | Añadido en septiembre de 2026 en ambos sistemas; antes en ninguno |
| Baneos automáticos por fuerza bruta | ✅ | ✅ | Antes solo en Grafana |
| Tráfico en el borde (CDN): eventos de firewall | ✅ | ✅ | |
| Tráfico en el borde (CDN): métricas HTTP/DNS | ✅ | ✅ | |
| Host/contenedores/almacenamiento (ZFS, SMART, térmica) | ✅ | ✅ | Un campo de CPU del host da 0 en ambos por un bug conocido de la API de Proxmox; tareas y errores del hipervisor solo en Splunk |
| Base de datos (MariaDB) | ✅ | ✅ | |
| Streaming multimedia (uso de biblioteca) | ✅ | ✅ | Añadido en septiembre de 2026 |
| Métricas de sistema operativo (tipo node_exporter) | ❌ | ❌ | Siguiente paso |
| Logs de sistema (syslog/auth/journal de los contenedores) | ❌ | ❌ | Pendiente |
Tabla de paridad Splunk↔Grafana tal como quedó tras la ronda de cambios de mediados de septiembre de 2026.
Stack:
- Grafana + InfluxDB 1.8 + Loki (contenedores Docker)
- Splunk Enterprise (edición gratuita)
- Python (colectores propios, librería estándar, sin dependencias externas)
- systemd + cron para la ejecución periódica
- nginx (log adicional en JSON para rendimiento real)
- MariaDB (slow query log + estado en caliente)
- ModSecurity (WAF) como fuente de eventos de seguridad